
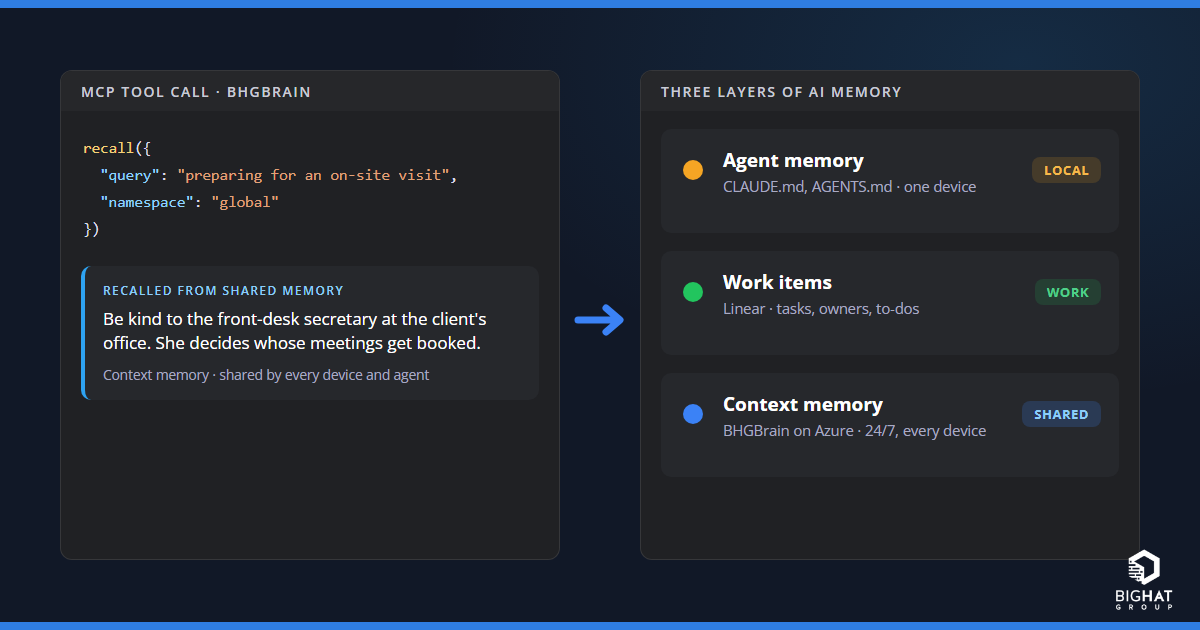
我一天會用到很多 AI 代理:終端機裡的 Claude Code、VS Code 裡的 GitHub Copilot、另一台機器上的 Codex、Cloud PC 上的 OpenClaw,還有建置代理上的幾支指令碼。很長一段時間,它們各自把記憶關在自己的孤島裡。Claude Code 在我筆電上學到的事,桌機上的 Copilot 一無所知。我星期二告訴某個助理的事,星期四又得再解釋一遍。
過去一年,我逐漸形成一套思考 AI 記憶的方式,解決了大部分的問題。它分成三層,而第三層正是我們的開源記憶伺服器 BHGBrain 發揮價值的地方。這篇文章會說明這三層,再介紹讓第三層運作起來的架構:一台 BHGBrain 伺服器在 Azure 的小型 Linux VM 上全天候執行,每台裝置、每個代理都能透過 Tailscale 私下連線存取。
AI 記憶的三個層次
不是每一則資訊都該放在同一個地方。檢視我的代理需要知道的內容時,可以分成三類:
| 層次 | 存放位置 | 內容 | 範例 | 保存期限 |
|---|---|---|---|---|
| 1. 代理記憶 | 每個代理在單一裝置上的自有檔案與設定:CLAUDE.md、AGENTS.md、內建記憶 | 如何用這個工具在這個專案中工作 | 「每次 commit 前先執行 linter。」 | 與專案同在 |
| 2. 工作項目 | Linear 這類工單系統 | 待辦事項、負責人與狀態 | 「星期五前更新客戶的憑證。」 | 直到工單結案 |
| 3. 情境記憶 | BHGBrain,由每台裝置與每個代理共用 | 你所知道、既不是任務也不是專案規則的事 | 「對客戶辦公室櫃檯的秘書要以禮相待。誰的會議能排進行程,由她決定。」 | 只要仍然有用就一直保留 |
前兩層大家都很熟悉。代理指示檔 告訴工具在某個儲存庫中該如何運作。Linear 負責管理工作:每個待辦事項都有負責人、狀態與終點。
第三層則是多數人缺少的一塊。以秘書的例子來說,它不是任務,所以在 Linear 裡沒有東西可以開啟或結案。它也不是專案規則:你不會把它寫進每個程式開發工作階段都會載入的 CLAUDE.md,更不會把它 commit 到共用的儲存庫。然而,當助理協助你準備拜訪那間辦公室時,這正是你希望它記得的事。
許多有用的知識都長這個樣子:
- 某位客戶偏好在早上 10:00 前開會,而且很討厭臨時加進議程的項目;
- 上次某款筆電的 VPN 斷線時,最後奏效的修正方法;
- 客戶的哪個租用戶是正式環境,哪個是測試副本;
- 某項決策為什麼這樣做,而不只是決定了什麼;
- 那位會回 email、但從不接電話的廠商聯絡窗口。
這些都不是任務,也都不是給程式碼庫的指示。它們是情境脈絡:一位好同事自然會記得的那種事。BHGBrain 讓你的代理有個地方可以保存這些內容。
為什麼情境層必須集中管理
你可以在自己的筆電上執行 BHGBrain,這也是試用它的好方法。但放在筆電上的記憶,就只是屬於這台筆電的記憶。筆電一闔上它就離線,而桌機、Cloud PC、WSL 環境與建置代理都得從零開始。
我的 AI 生態系不只是一台裝置或一家廠商,我想你的應該也不是。要讓情境層真正有用,它必須:
- 永遠在線,一天 24 小時,任何代理隨時都能存取;
- 每台裝置都能連到,不論是 Windows、macOS、Linux、WSL 或 Windows 365 Cloud PC;
- 每個代理都能使用,只要支援 Model Context Protocol(MCP)即可,不綁定單一工具;
- 具有隱私性,因為它存放的正是你絕不會公開張貼的那類筆記;
- 屬於你自己,存在你自己的訂用帳戶中,備份與保留都由你掌控;
- 成本低廉,因為它只是一個人或一個小團隊的記憶。
這份清單指向的是一台你自己擁有、位於私人網路上的小型伺服器。以下是我使用的設計。
架構:Azure Linux VM 上的 BHGBrain
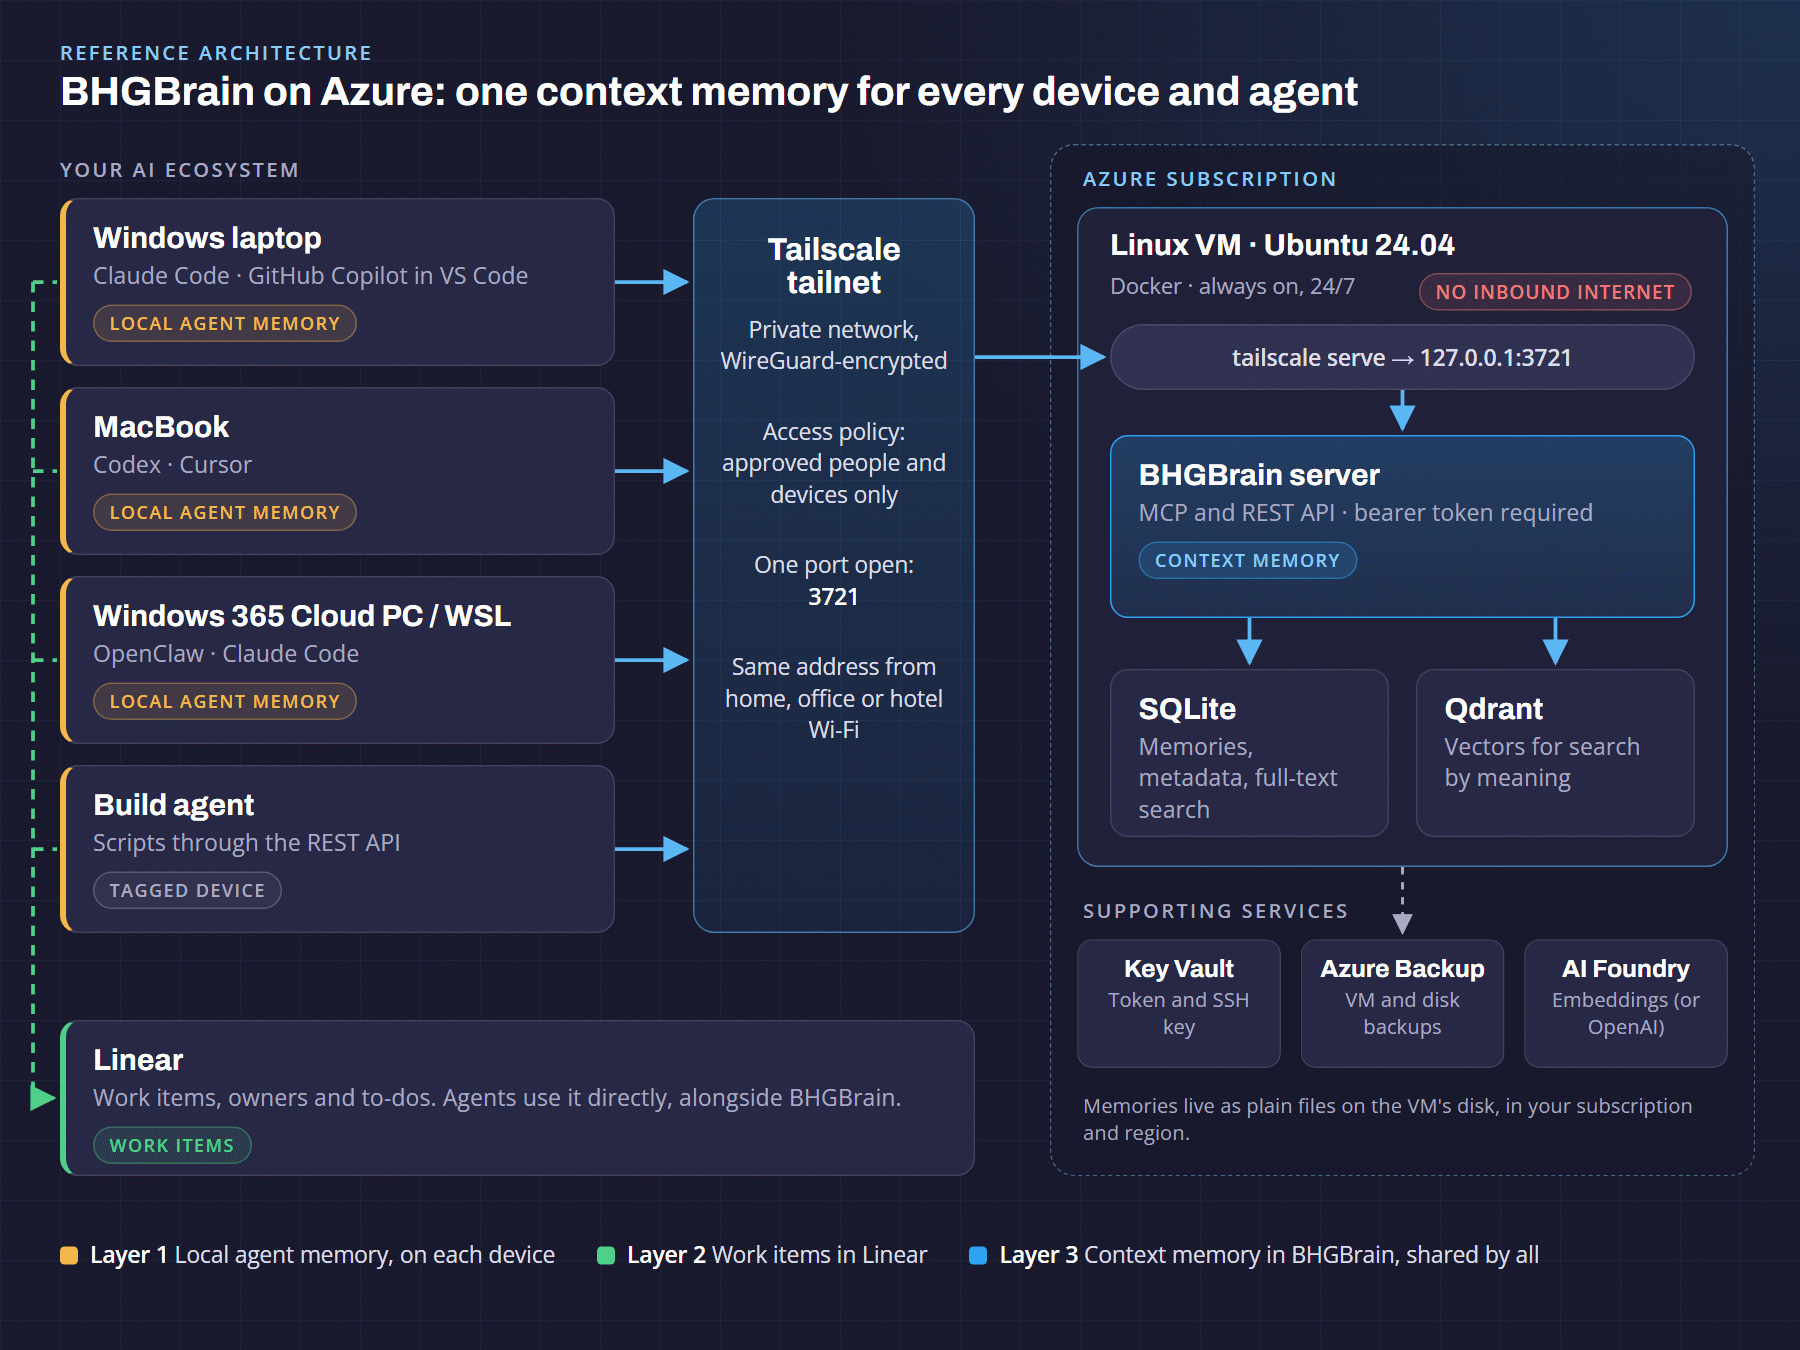
由左至右閱讀這張圖:
- 你的裝置與代理。每台筆電、桌機、Cloud PC 或建置代理照常執行各自的 AI 工具,每個工具也保有自己的本機記憶(第一層)。這些工具也會與 Linear 互動以處理工作項目(第二層)。至於第三層,它們全都指向同一個位址:BHGBrain 伺服器。
- 私人的 Tailscale 網路。每台裝置都執行 Tailscale,無論裝置身在何處,它都會在你的裝置之間建立一個加密網路(稱為「tailnet」)。存取原則決定誰可以連到記憶伺服器,以及可以使用哪個連接埠。tailnet 以外的人完全看不到它。
- Azure 上的一台 Linux VM。一台小型 Ubuntu VM 以 Docker 執行兩個容器:BHGBrain 伺服器,以及它用來做語意搜尋的向量資料庫 Qdrant。BHGBrain 將記憶本身存放在 VM 磁碟上的 SQLite 中。VM 的網路安全性群組沒有任何輸入規則,所以網際網路上的任何東西都無法連到它。
- 輔助的 Azure 服務。Key Vault 保管 SSH 金鑰與存取權杖。Azure Backup 保護磁碟。嵌入(讓依意義搜尋得以運作的數值「指紋」)來自 OpenAI,或來自 Azure AI Foundry,後者能讓這些流量留在你自己的租用戶內。
當代理記住某件事時會發生什麼
假設我正在筆電上使用 Claude Code,並告訴它:「記住,客戶的變更時段是每週四晚上,核准要送給他們的 IT 主管。」
- Claude Code 將一個
remember要求送到 BHGBrain 伺服器在 tailnet 上的位址。 - Tailscale 檢查存取原則。我的筆電獲准存取,因此要求透過加密通道傳到 VM。
- BHGBrain 檢查要求的存取權杖,篩檢內容中是否有任何看起來像密碼或 API 金鑰的東西,並確認自己是否已經知道這件事。
- 它將記憶存入 SQLite、將嵌入存入 Qdrant,並指定一個決定這筆記憶能保存多久的保留層級。
當天下午,我在桌機上用 VS Code 裡的 Copilot 問:「客戶的變更時段是什麼時候?」立刻就得到答案,即使這筆記憶是從另一台機器、另一個工具存進去的。
為什麼選擇 Azure 上的 Linux VM
架設記憶伺服器有更簡單的方式,也有更花俏的方式。對個人或小團隊來說,單一 VM 剛好落在最佳平衡點:
- 它永遠在線。不論是早上 6 點用手機熱點,還是半夜從 Cloud PC 連線,記憶都在那裡。
- 它很簡單。兩個容器加一個設定檔。更新只需要
git pull再重新啟動。重新開機後,Docker 會把一切帶回來。 - 它與你已經在用的 Azure 工具相容。Azure Backup、Key Vault、Azure Monitor 與 Azure AI Foundry 都能直接整合。
- 你的資料留在你放置的地方。記憶就是存放在你訂用帳戶中、你所選區域磁碟上的一般檔案;如果你在意資料落地 ,這點就很重要。
- 它很便宜。一台小型 VM,而不是一整個叢集。
與其他替代方案的比較:
| 選項 | 你得到什麼 | 代價 |
|---|---|---|
| 每台裝置各放一份副本 | 不需要架設任何東西 | 每台裝置各有一份記憶,彼此無法延續。 |
| 搭配 TLS 的公開端點 | 從任何地方都能連到,包括雲端託管的助理 | 一台面向網際網路、裝滿私人筆記的伺服器,只靠一個權杖保護。TLS、防火牆規則與修補風險都得由你自己承擔。 |
| 受控容器服務 | 沒有作業系統需要修補 | 對一人規模的工作負載而言,持久性資料庫與私人網路會增加成本與複雜度。 |
| 一台 Linux VM + Tailscale | 每台裝置、每個代理共用一份記憶,永遠在線,沒有公開連接埠 | 一台 VM 就是單一失敗點,所以務必做好備份。 |
為什麼用 Tailscale,而不是開放連接埠
要從任何地方連到伺服器,常見做法是對網際網路開放一個連接埠,再在前面加上登入機制。但對一台整個工作就是記住私人事物的伺服器來說,我寧可不這麼做。
使用 Tailscale:
- 沒有來自網際網路的輸入連接埠。VM 不接受任何來自網際網路的連線。Tailscale 只建立輸出連線,並由此建構私人網路。
- 以人員與裝置為單位授予存取權。存取原則指定一個允許使用記憶伺服器的人員群組,並只對他們開放那一個連接埠。系統管理員另外可以使用 SSH。tailnet 上的其他人都無法連線,更不用說網際網路上的人。
- 兩道鎖,而不是一道。光是在 tailnet 內還不夠,每個要求仍然需要 BHGBrain 的 Bearer 權杖。
- 筆電遺失?按一下就搞定。在 Tailscale 管理主控台中移除裝置,就能立即切斷它的存取。
- 全程加密。流量在 WireGuard 通道內傳輸,因此即使在 tailnet 內使用一般 HTTP,從裝置到 VM 也已經是加密的。
- 在哪裡都一樣。在家、在辦公室、在飯店 Wi-Fi,或在客戶的訪客網路上:位址永遠相同。
它如何像第二大腦一樣運作
第二大腦只有在你能放心把東西丟進去、不必擔心變得雜亂時才有用。BHGBrain 的保留層級 正是讓這件事成為可能的關鍵:
| 層級 | 通常會放進哪些內容 | 未使用時的保存期限 |
|---|---|---|
| T3,暫時性 | 工單編號、email 摘要、「今天」與「星期五前」之類的筆記 | 30 天 |
| T2,營運性(預設) | 會議結論、專案狀態、進行中的調查 | 90 天 |
| T1,制度性 | 決策、操作說明、廠商與系統細節 | 365 天 |
| T0,基礎性 | 政策、常設規則、你的個人檔案 | 永不到期 |
有三種行為讓它感覺起來像記憶,而不只是儲存空間:
- 使用會讓記憶保持鮮活。每次回想某筆記憶,它的計時就會重設。你會用到的知識永遠不會到期。你從未用到的知識會自動清理,而且會先進入封存區,以便日後還原。
- 一再需要的東西會被升級。一筆被回想五次的記憶會往上升一個層級。那個你老是在查的「零碎」事實,不需要你做任何事就會變成長期知識。
- 正確的情境在正確的時機出現。在工作階段開始時,代理可以載入你的常設規則、釘選的記憶,以及與手上任務最相關的記憶,而不是一個包山包海的巨大檔案。
另外還有一些內務整理。重複的內容會被合併,而不是越堆越多。標籤會自動加上。任何看起來像認證資訊的東西都會在儲存前被拒絕,對一個你整天都在餵資料的大腦來說,這點很重要。如果你啟用它,每晚還會執行一個「提煉」工作,把一群相關的短期筆記濃縮成一則持久的事實。
第一天,BHGBrain 內建的入門訪談會把你的角色、你的客戶與你的環境記錄為永久記憶,讓每台裝置上的每個代理從一開始就知道你是誰。
跨裝置的一天
為了更具體,以下是示意性的一天:
- 08:30,Windows 筆電,Claude Code:「記住,客戶的變更時段是每週四晚上。」儲存為一則營運性事實。
- 09:15,同一台筆電:「記下工單 INC-4821:VPN 在 Wi-Fi 6E 網路卡上會斷線;停用 6 GHz 即可修正。」工單編號讓它被標記為暫時性。
- 13:00,桌機,VS Code 中的 Copilot:「客戶的變更時段是什麼時候?」立即從共用記憶中得到答案。
- 15:30,MacBook,Codex:準備到客戶現場拜訪時,代理回想起關於櫃檯秘書的那則筆記,以及客戶的會議偏好。
- 17:00,Cloud PC,OpenClaw:開始一個工作階段,預先載入客戶的常設規則與近期決策。
- 下週:那個 VPN 因應做法已經從三台機器被回想過,因此升級到保存更久的層級。那些沒人需要的一次性筆記則悄悄到期。
四台裝置上的五個工具,沒有一個需要被告知同一件事兩次。
成本是多少
| 項目 | 大約成本 | 備註 |
|---|---|---|
Linux VM,2 vCPU 與 8 GiB 記憶體(Standard_B2ms) | 以隨用隨付價格計算,每月大約 US$60–70 | 4 GiB 的規格大約便宜一半,適合個人使用。保留執行個體與節省方案還能再降低成本。請用 Azure 定價計算機查詢你所在區域的價格。 |
| 磁碟、供輸出流量使用的公用 IP、Key Vault、備份 | 每月從幾美元到十幾美元 | 取決於磁碟類型與備份保留期間 |
| Tailscale | Personal 方案免費 | Personal 方案僅限非商業用途,最多六位使用者。商業用途需要付費方案。 |
嵌入(OpenAI text-embedding-3-small) | 每百萬 token US$0.02 | 數千筆記憶只需要幾分錢 |
一份由你使用的每個 AI 工具共用的私人記憶,花費大約等於幾個串流影音訂閱。
需要了解的取捨
沒有任何設計是毫無妥協的。以下是我希望主管一開始就知道的幾點:
- 雲端託管的連接器無法連到它。在網頁版或手機版 claude.ai 上新增的連接器是從廠商的雲端執行,而那不在你的 tailnet 內。在你自己裝置上執行的代理則完全沒問題。這是讓伺服器不暴露在網際網路上所付出的代價。
- 只有一個共用的存取權杖。Tailscale 控制哪些人員與裝置可以進入。權杖則是每個人都相同,所以有人離開時請輪替權杖。
- 一台 VM 就是一個失敗點。請備份記憶檔案與 VM。向量資料庫如果遺失,可以從記憶重新建立。
- 嵌入會離開 VM。記憶的文字會被送到嵌入服務提供者。使用 Azure AI Foundry 可以讓這部分留在你自己的租用戶內。
- 審慎考量要儲存什麼。關於人的筆記,應該是那種即使當事人讀到你也不會感到尷尬的專業內容。命名空間能讓每位客戶的情境脈絡彼此分開。
開始使用
完整的逐步教學放在 BHGBrain 儲存庫中:Deploying BHGBrain on an Azure Linux VM with Tailscale 。概略來說:
準備 tailnet。為伺服器加上標記、建立一個使用者群組,並只允許該群組連到記憶伺服器的連接埠。
建立 VM。一台沒有任何輸入防火牆規則的小型 Ubuntu VM,其 SSH 金鑰存放在 Key Vault 中。
安裝 Docker 與 Tailscale。Azure 的「執行命令」功能不必對網際網路開放 SSH 就能完成這件事。
啟動 BHGBrain。複製儲存庫、加入存取權杖與嵌入金鑰,然後啟動兩個容器。
在 tailnet 上發布。一個
tailscale serve指令就能讓每台裝置都透過同一個位址連到它。連接每台裝置。安裝 Tailscale,然後把伺服器加入每個 AI 工具。在 Claude Code 中只需要一個指令:
claude mcp add --transport http --scope user bhgbrain \ http://bhgbrain:3721/mcp --header "Authorization: Bearer <token>"讓它認識你。執行一次入門訪談,每個代理都會因此受惠。
你該怎麼做
如果你的團隊使用不只一種 AI 工具,或在不只一台機器上使用同一個工具,那麼你已經遇到這套架構要解決的問題。我的建議如下:
- 為這三層命名。說好哪些內容放進代理指示檔、哪些放進 Linear、哪些放進共用的情境記憶。一旦大家知道東西該放哪裡,大部分的摩擦就會消失。
- 從一個人開始。先在一台小型 VM 上為自己執行 BHGBrain 一個月。它的價值會體現在你需要重複說明的次數變得多麼少。
- 預設保持私密。沒有公開連接埠、設定 Tailscale 存取規則、使用 Bearer 權杖,並從第一天起就做好備份。
- 有計畫地擴展。透過 Tailscale 群組加入團隊成員、用命名空間區隔各個客戶,並一起決定這份記憶應該、以及不應該存放什麼。
如果你需要協助設計 Azure 端架構、存取模型,或規劃記憶如何融入更大範圍的代理導入計畫,這正是我們的 AI 自動化 與 Azure 顧問 服務所做的工作。
常見問題
什麼是 AI 第二大腦?
一份共用的長期記憶,讓你的 AI 助理能跨工作階段寫入與回想。你不必在每次對話中重新解釋客戶、環境與偏好,助理會把學到的東西儲存起來,之後再取回相關的片段。BHGBrain 透過 Model Context Protocol 提供這項能力,因此任何支援 MCP 的代理都能使用。
BHGBrain 與 CLAUDE.md、AGENTS.md 或代理內建的記憶有什麼不同?
本機代理記憶告訴一個工具如何在一台裝置上的一個專案中工作,而且通常每個工作階段都會完整載入。BHGBrain 是獨立且共用的一層,存放跨專案、跨裝置、跨工具的情境脈絡:人員、偏好、環境細節、經驗教訓與決策。它只取回與當下任務相關的內容。
為什麼要把 BHGBrain 放在 Azure VM 上,而不是我的筆電?
放在筆電上的副本只是那台筆電的記憶,而且筆電離線時它也跟著離線。Azure 上的小型 Linux VM 全天候運作,因此每台裝置與每個代理都共用同一份記憶,你還能使用 Azure Backup、Key Vault,並可選擇透過 Azure AI Foundry 在租用戶內產生嵌入。
把 AI 記憶伺服器放在雲端安全嗎?
在這個設計中,VM 沒有任何來自網際網路的輸入連接埠。裝置透過私人的 Tailscale 網路連線,只有經過核准的人員與裝置能加入,而且每個要求仍然需要 Bearer 權杖。BHGBrain 也會在儲存前拒絕看起來像密碼或 API 金鑰的內容。
哪些 AI 工具可以使用共用的 BHGBrain 伺服器?
任何在你 tailnet 內裝置上、能連線到遠端 MCP 伺服器的 MCP 用戶端,例如 Claude Code、Codex、VS Code 中的 GitHub Copilot、Cursor 與 OpenClaw,以及使用 REST API 的指令碼。只能啟動本機伺服器的桌面應用程式,可以透過一個小型的本機橋接程式使用。雲端託管的連接器則無法連到只存在於 tailnet 內的伺服器。
資料來源
- BHGBrain on GitHub ,專案 README 與文件
- Deploying BHGBrain on an Azure Linux VM with Tailscale ,BHGBrain 儲存庫
- tailscale serve 指令 ,Tailscale 文件
- Tailscale 定價 與 2026 年 4 月定價更新 ,Tailscale
- Azure 中的預設輸出存取 ,Microsoft Learn(說明為何 VM 需要明確的輸出路徑)
- text-embedding-3-small ,OpenAI 文件