
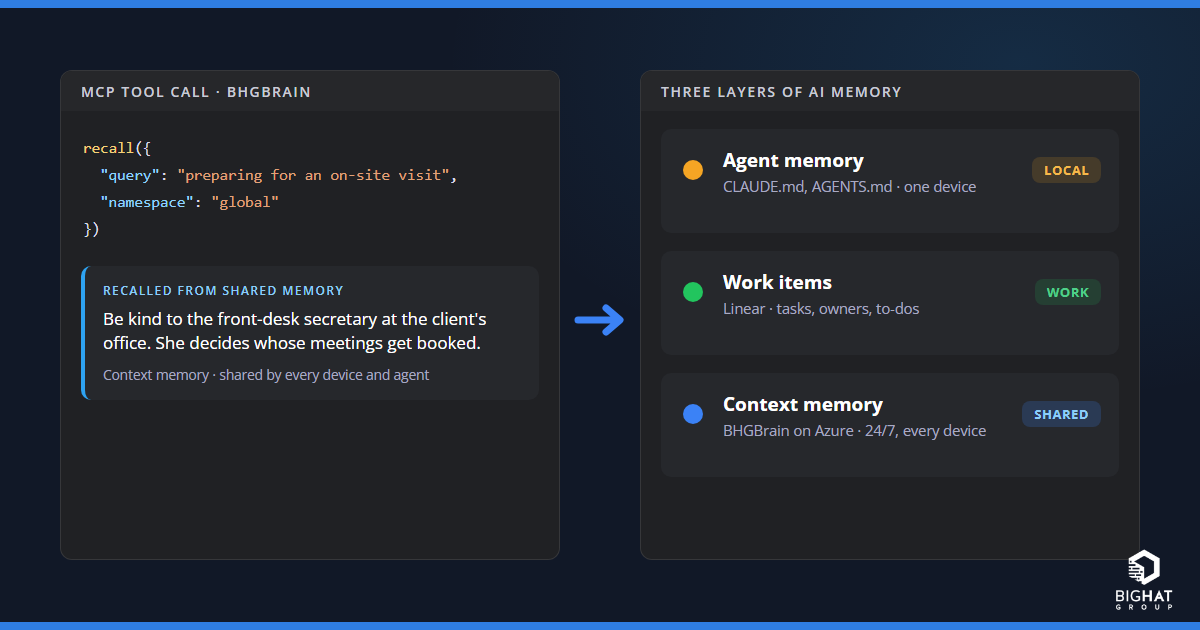
我一天要用很多 AI 智能体:终端里的 Claude Code、VS Code 里的 GitHub Copilot、另一台机器上的 Codex、云电脑上的 OpenClaw,还有构建代理上的一堆脚本。很长一段时间里,它们各自在自己的孤岛里记东西。Claude Code 在我笔记本上学到的,台式机上的 Copilot 一无所知。周二告诉某个助手的事情,到了周四我又得重新解释一遍。
过去一年里,我形成了一套思考 AI 记忆的方式,基本解决了这个问题。它分为三层,而第三层正是我们的开源记忆服务器 BHGBrain 大显身手的地方。本文先解释这三层,然后介绍让第三层运转起来的架构:在 Azure 中一台小型 Linux 虚拟机上全天候运行一个 BHGBrain 服务器,每台设备、每个智能体都通过 Tailscale 私密地访问它。
AI 记忆的三个层次
并不是所有信息都该放在同一个地方。当我审视我的智能体需要知道什么时,会发现它们分成三类:
| 层次 | 存放位置 | 存放内容 | 示例 | 保存多久 |
|---|---|---|---|---|
| 1. 智能体记忆 | 每个智能体在单台设备上的文件和设置:CLAUDE.md、AGENTS.md、内置记忆 | 如何用这个工具在这个项目里工作 | “每次提交前先运行 linter。” | 与项目同在 |
| 2. 工作项 | Linear 这样的工单系统 | 要做的事、负责人、当前状态 | “周五前续订客户的证书。” | 直到工单关闭 |
| 3. 上下文记忆 | BHGBrain,由所有设备和智能体共享 | 你所知道的、既不是任务也不是项目规则的东西 | “对客户办公室的前台秘书要客气、尊重。谁的会议能排进日程,由她决定。” | 只要仍然有用 |
前两层大家都很熟悉。智能体指令文件 告诉工具在某个仓库中如何行事。Linear 承载工作:每个待办事项都有负责人、状态和终点。
第三层才是大多数人缺失的。就拿前台秘书这个例子来说。它不是任务,所以在 Linear 里没有什么可以新建或关闭的。它也不是项目规则:你不会把它写进每次编码会话都会加载的 CLAUDE.md,更不会把它提交到共享仓库里。可是当助手帮你准备拜访那家客户的办公室时,这恰恰是你希望它记得的事情。
很多有用的知识都是这个样子:
- 某位客户喜欢把会议安排在上午 10:00 之前,并且讨厌临时加进来的议程;
- 上次某个型号的笔记本电脑 VPN 掉线时奏效的修复方法;
- 客户的哪个租户是生产环境,哪个是测试副本;
- 某个决定为什么这样做,而不只是决定了什么;
- 那位只回邮件、从不接电话的供应商联系人。
这些都不是任务,也都不是给代码库的指令。它们是上下文:一位好同事自然而然就会记住的那类东西。BHGBrain 为你的智能体提供了一个存放它们的地方。
为什么上下文层必须集中
你可以在自己的笔记本电脑上运行 BHGBrain,作为试用方式这完全没问题。但笔记本上的记忆只是这台笔记本的记忆。笔记本一合上它就离线了,而台式机、云电脑、WSL 环境和构建代理都只能从零开始。
我的 AI 生态并不是一台设备或一家厂商,我猜你的也不是。要让上下文层真正有用,它需要:
- 始终在线,一天 24 小时,任何智能体随时都能访问;
- 可从每台设备访问,无论是 Windows、macOS、Linux、WSL 还是 Windows 365 云电脑;
- 可被每个智能体使用,只要它支持 Model Context Protocol (MCP),不绑定某一个工具;
- 私密,因为它存放的恰恰是你绝不会公开发布的那类笔记;
- 归你所有,存在你自己的订阅中,由你掌控备份和保留策略;
- 成本低廉,因为它只是一个人或一个小团队的记忆。
这份清单指向的是一台你自己拥有、位于私有网络上的小型服务器。下面是我使用的设计。
架构:Azure Linux 虚拟机上的 BHGBrain
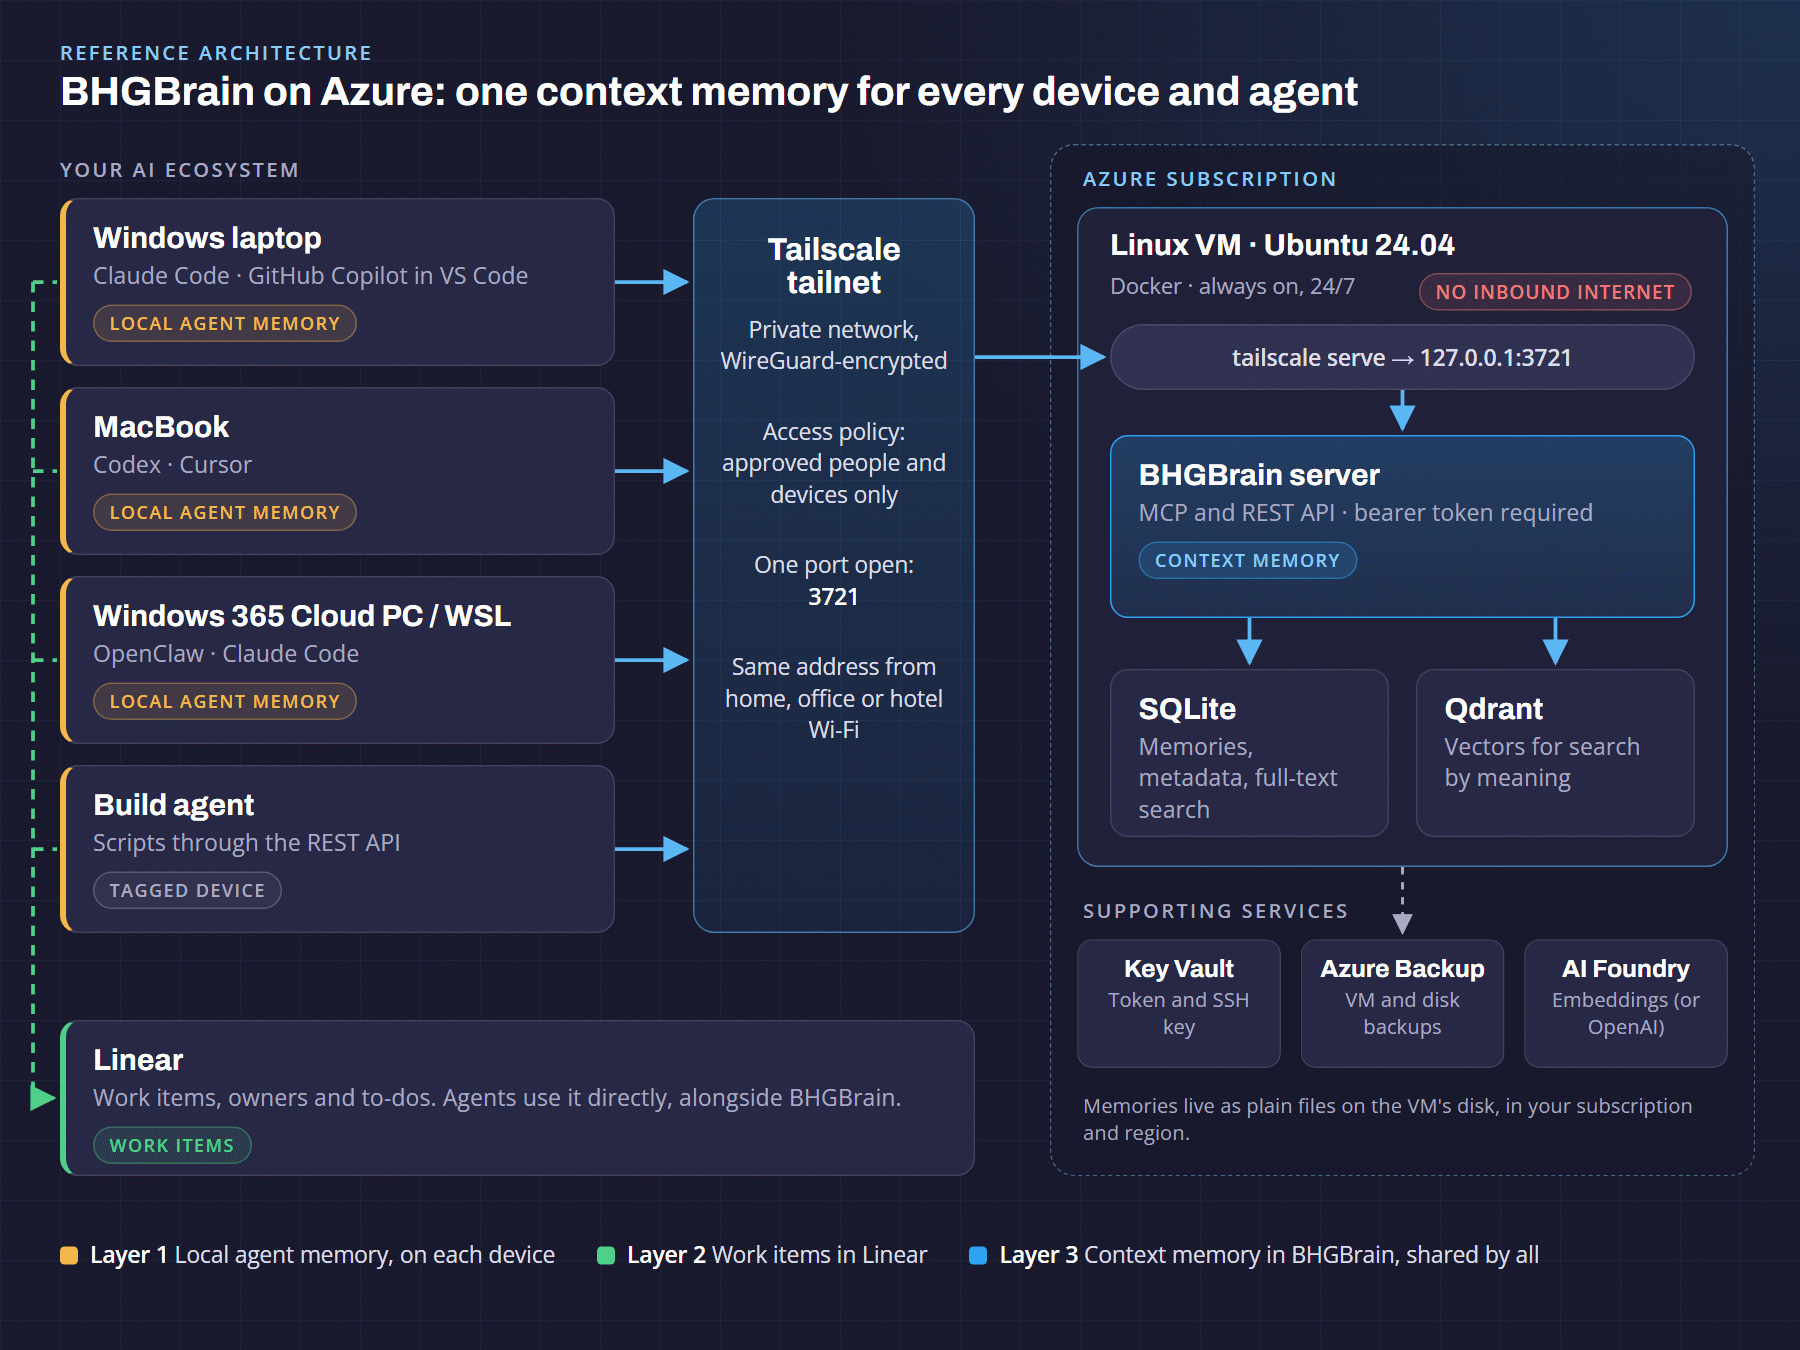
从左到右解读这张图:
- 你的设备和智能体。每台笔记本、台式机、云电脑或构建代理照常运行它的 AI 工具,每个工具保留自己的本地记忆(第一层)。工具还会与 Linear 交互来处理工作项(第二层)。对于第三层,它们都指向同一个地址:BHGBrain 服务器。
- 私有的 Tailscale 网络。每台设备都运行 Tailscale,它会在你的设备之间(无论它们身在何处)构建一个加密网络(即 “tailnet”)。一条访问策略决定谁可以访问记忆服务器、可以访问哪个端口。tailnet 之外的任何人都看不到它。
- Azure 中的一台 Linux 虚拟机。一台小型 Ubuntu 虚拟机用 Docker 运行两个容器:BHGBrain 服务器,以及它用于按含义搜索的向量数据库 Qdrant。BHGBrain 把记忆本身保存在虚拟机磁盘上的 SQLite 中。虚拟机的网络安全组没有任何入站规则,因此互联网上的任何东西都无法访问它。
- 配套的 Azure 服务。Key Vault 保存 SSH 密钥和访问令牌。Azure Backup 保护磁盘。嵌入(让按含义搜索成为可能的数值“指纹”)来自 OpenAI 或 Azure AI Foundry,后者能让这部分流量留在你自己的租户内。
智能体记住一件事时会发生什么
假设我在笔记本上的 Claude Code 里对它说:“记住,这家客户的变更窗口是每周四晚上,审批要发给他们的 IT 负责人。”
- Claude Code 向 BHGBrain 服务器在 tailnet 上的地址发送一个
remember请求。 - Tailscale 检查访问策略。我的笔记本是被允许的,所以请求经由加密隧道到达虚拟机。
- BHGBrain 校验请求的访问令牌,筛查内容中是否有看起来像密码或 API 密钥的东西,并检查自己是否已经知道这条事实。
- 它把记忆存入 SQLite,把它的嵌入存入 Qdrant,并为它分配一个决定其存活时长的保留层级。
当天下午,在我的台式机上,VS Code 中的 Copilot 问“这家客户的变更窗口是什么时候?”,立刻就得到了答案,尽管这条记忆是在另一台机器、用另一个工具保存的。
为什么选择 Azure 中的 Linux 虚拟机
托管记忆服务器有更简单的方式,也有更花哨的方式。对个人或小团队而言,一台虚拟机恰好处在最佳平衡点:
- 它始终在线。无论是早上 6 点用手机热点,还是午夜从云电脑访问,记忆都在那里。
- 它很简单。两个容器加一个配置文件。更新只需一次
git pull加一次重启。重启后 Docker 会把一切恢复起来。 - 它与你已在使用的 Azure 工具契合。Azure Backup、Key Vault、Azure Monitor 和 Azure AI Foundry 都能直接接入。
- 你的数据留在你指定的地方。记忆是你订阅中、你所选区域里磁盘上的普通文件,如果你关心数据驻留 ,这一点很重要。
- 它成本低廉。一台小型虚拟机,而不是一个集群。
与其他方案的比较:
| 方案 | 你得到什么 | 代价 |
|---|---|---|
| 每台设备各存一份副本 | 无需托管任何东西 | 每台设备各有一份独立记忆,什么都不会同步过去。 |
| 带 TLS 的公共端点 | 可从任何地方访问,包括云端托管的助手 | 一台面向互联网、装满私密笔记的服务器,只靠一个令牌保护。TLS、防火墙规则和补丁风险都由你承担。 |
| 托管容器 | 无需给操作系统打补丁 | 对一个人的工作负载而言,持久化数据库和私有网络会增加成本和复杂度。 |
| 一台 Linux 虚拟机 + Tailscale | 所有设备和智能体共享一份记忆,始终在线,没有公共端口 | 一台虚拟机就是单点故障,所以要做好备份。 |
为什么用 Tailscale 而不是开放端口
要从任何地方访问一台服务器,通常的做法是向互联网开放一个端口,再在前面加一道登录。对于一台全部职责就是记住私密信息的服务器,我宁愿不这么做。
使用 Tailscale:
- 没有入站互联网端口。虚拟机不接受任何来自互联网的连接。Tailscale 发起出站连接,并由此构建私有网络。
- 访问控制精确到人和设备。访问策略指定一组允许使用记忆服务器的人员,并且只向他们开放那一个端口。管理员另外获得 SSH 访问权限。你 tailnet 上的其他任何人都无法连接,更不用说互联网了。
- 两把锁,而不是一把。身处 tailnet 中还不够。每个请求仍然需要 BHGBrain 的 bearer token。
- 笔记本丢了?点一下就行。在 Tailscale 管理控制台中移除设备,它就会立即被切断。
- 全程加密。流量在 WireGuard 隧道中传输,因此 tailnet 内部的普通 HTTP 从设备到虚拟机本身就是加密的。
- 在哪里都一样。家里、办公室、酒店 Wi-Fi 或客户的访客网络:地址始终不变。
它如何像第二大脑一样运作
第二大脑只有在你可以随手往里扔东西、而不必担心杂乱时才管用。BHGBrain 的保留层级 正是让这一点成为可能的关键:
| 层级 | 通常存放什么 | 无人使用时保存多久 |
|---|---|---|
| T3,临时 | 工单号、邮件摘要、“今天”和“周五前”之类的笔记 | 30 天 |
| T2,运营级(默认) | 会议结论、项目状态、正在进行的调查 | 90 天 |
| T1,机构级 | 决策、操作方法、供应商和系统细节 | 365 天 |
| T0,基础级 | 政策、长期规则、你的个人档案 | 永不过期 |
有三种行为让它感觉像记忆,而不只是存储:
- 使用让记忆保持鲜活。每次调用一条记忆,它的计时都会重置。你用到的知识永不过期。你从不用到的知识会自行清理,而且会先进入归档,以便需要时恢复。
- 你反复需要的东西会被提升。被调用五次的记忆会上升一个层级。你总是要去查的那条“零碎”事实,不用你做任何事就会变成长期知识。
- 合适的上下文在合适的时间出现。会话开始时,智能体可以加载你的长期规则、置顶记忆以及与当前任务最相关的记忆,而不是一个包罗万象的巨型文件。
此外还有日常整理工作。重复内容会被合并,而不是越堆越多。标签会自动添加。任何看起来像凭据的内容都会在存储前被拒绝,对于一个你整天往里喂东西的大脑来说,这一点很重要。如果你启用它,还有一个夜间“提炼”任务会把一簇相关的短期笔记浓缩成一条持久的事实。
第一天,BHGBrain 内置的入门访谈会把你的角色、你的客户和你的环境记录为永久记忆,因此每台设备上的每个智能体一开始就知道你是谁。
跨设备的一天
为了更具体,下面是示意性的一天:
- 08:30,Windows 笔记本,Claude Code:“记住,这家客户的变更窗口是每周四晚上。”作为一条运营级事实存储。
- 09:15,同一台笔记本:“记录工单 INC-4821:VPN 在 Wi-Fi 6E 网卡上会掉线;禁用 6 GHz 即可解决。”工单号让它被标记为临时。
- 13:00,台式机,VS Code 中的 Copilot:“这家客户的变更窗口是什么时候?”立刻从共享记忆中得到回答。
- 15:30,MacBook,Codex:在准备一次现场拜访时,智能体调出了关于前台秘书的那条笔记,以及这家客户的会议偏好。
- 17:00,云电脑,OpenClaw:启动会话时已预先载入这家客户的长期规则和近期决策。
- 下一周:那条 VPN 应对方法已经从三台机器上被调用过,因此被提升到存活时间更长的层级。没人需要的一次性笔记则悄然过期。
四台设备上的五个工具,没有一个需要被告知同一件事两次。
成本是多少
| 项目 | 大致成本 | 说明 |
|---|---|---|
Linux 虚拟机,2 个 vCPU 和 8 GiB 内存(Standard_B2ms) | 按即用即付价格计算,每月约 60–70 美元 | 4 GiB 规格的成本约为一半,适合个人使用。预留实例和节省计划还能进一步降低成本。请使用 Azure 定价计算器查看你所在区域的价格。 |
| 磁盘、用于出站流量的公共 IP、Key Vault、备份 | 每月几美元到十几美元 | 取决于磁盘类型和备份保留期 |
| Tailscale | Personal 计划免费 | Personal 计划仅限非商业用途,最多六个用户。商业用途需要付费计划。 |
嵌入(OpenAI text-embedding-3-small) | 每百万 token 0.02 美元 | 数千条记忆只需几美分 |
一份由你使用的所有 AI 工具共享的私有记忆,价格大约相当于几个流媒体订阅。
需要了解的权衡
没有哪个设计是毫无妥协的。以下这些是我希望管理者一开始就知道的:
- 云端托管的连接器无法访问它。在网页版或手机上的 claude.ai 中添加的连接器运行在厂商的云端,而那里不在你的 tailnet 上。运行在你自己设备上的智能体则完全没问题。这是让服务器远离互联网所付出的代价。
- 只有一个共享访问令牌。Tailscale 控制哪些人和设备可以进入。令牌对所有人都一样,所以有人离开时要轮换它。
- 一台虚拟机就是一个故障点。备份记忆文件和虚拟机。即使向量数据库丢失,也可以根据记忆重建。
- 嵌入会离开虚拟机。记忆文本会被发送给嵌入提供商。使用 Azure AI Foundry 可以让这部分数据留在你自己的租户内。
- 想清楚你要存什么。关于他人的笔记应当是专业性质的、即使对方读到你也不会尴尬的内容。命名空间可以把每个客户的上下文分隔开。
入门
完整的分步指南位于 BHGBrain 仓库中:Deploying BHGBrain on an Azure Linux VM with Tailscale 。概括来说:
准备 tailnet。给服务器打上标签,创建一个用户组,并只允许该组访问记忆服务器的端口。
创建虚拟机。一台没有任何入站防火墙规则的小型 Ubuntu 虚拟机,其 SSH 密钥保存在 Key Vault 中。
安装 Docker 和 Tailscale。Azure 的 Run Command 可以在不向互联网开放 SSH 的情况下完成安装。
启动 BHGBrain。克隆仓库,添加访问令牌和嵌入密钥,然后启动两个容器。
在 tailnet 上发布它。一条
tailscale serve命令就能让它在每台设备上都通过同一个地址访问。连接每台设备。安装 Tailscale,然后把服务器添加到每个 AI 工具中。在 Claude Code 中只需一条命令:
claude mcp add --transport http --scope user bhgbrain \ http://bhgbrain:3721/mcp --header "Authorization: Bearer <token>"让它了解你是谁。运行一次入门访谈,每个智能体都会受益。
该怎么做
如果你的团队在使用不止一个 AI 工具,或者在不止一台机器上使用同一个工具,那么你已经遇到了这套方案要解决的问题。我的建议:
- 给三个层次命名。商定哪些内容放进智能体指令文件、哪些放进 Linear、哪些放进共享上下文记忆。一旦大家知道东西该放哪里,大部分摩擦就会消失。
- 从一个人开始。在一台小型虚拟机上为自己运行 BHGBrain 一个月。它的价值体现在你需要重复自己的次数少了多少。
- 默认保持私密。从第一天起就做到:没有公共端口、配置 Tailscale 访问规则、使用 bearer token,并做好备份。
- 有计划地扩展。通过 Tailscale 组添加队友,用命名空间分隔不同客户,并共同决定这份记忆应该存放什么、不应该存放什么。
如果你希望在 Azure 侧设计、访问模型,或记忆如何融入更广泛的智能体部署方面获得帮助,这正是我们 AI 自动化 和 Azure 咨询 业务所做的工作。
常见问题
什么是 AI 第二大脑?
一份共享的长期记忆,你的 AI 助手可以跨会话向其中写入并从中调用信息。你不必在每次对话中重新解释你的客户、环境和偏好,助手会把学到的东西存下来,之后再取回相关的部分。BHGBrain 通过 Model Context Protocol 提供这一能力,因此任何支持 MCP 的智能体都可以使用它。
BHGBrain 与 CLAUDE.md、AGENTS.md 或智能体内置记忆有何不同?
本地智能体记忆告诉一个工具如何在一台设备上的一个项目里工作,而且通常在每次会话时被完整加载。BHGBrain 是一个独立的共享层,存放跨项目、跨设备、跨工具的上下文:人员、偏好、环境细节、经验教训和决策。它只检索与当前任务相关的内容。
为什么要把 BHGBrain 托管在 Azure 虚拟机上,而不是我的笔记本电脑上?
笔记本电脑上的副本只是那台笔记本的记忆,笔记本一离线它就跟着离线。Azure 中的一台小型 Linux 虚拟机全天候运行,因此每台设备和每个智能体都共享同一份记忆,你还能获得 Azure Backup、Key Vault,并可选择借助 Azure AI Foundry 在租户内生成嵌入。
把 AI 记忆服务器放在云端安全吗?
在这个设计中,虚拟机没有入站互联网端口。设备通过私有的 Tailscale 网络访问它,只有经过批准的人员和设备才能加入该网络,而且每个请求仍然需要 bearer token。BHGBrain 还会在存储之前拒绝看起来像密码或 API 密钥的内容。
哪些 AI 工具可以使用共享的 BHGBrain 服务器?
任何运行在你 tailnet 内设备上、能够连接远程 MCP 服务器的 MCP 客户端,例如 Claude Code、Codex、VS Code 中的 GitHub Copilot、Cursor 和 OpenClaw,以及使用 REST API 的脚本。只能启动本地服务器的桌面应用可以借助一个小型本地桥接程序。云端托管的连接器无法访问仅限 tailnet 的服务器。
参考来源
- BHGBrain on GitHub ,项目 README 和文档
- Deploying BHGBrain on an Azure Linux VM with Tailscale ,BHGBrain 仓库
- tailscale serve 命令 ,Tailscale 文档
- Tailscale 定价 和 2026 年 4 月定价更新 ,Tailscale
- Azure 中的默认出站访问 ,Microsoft Learn(说明为什么虚拟机需要显式的出站路径)
- text-embedding-3-small ,OpenAI 文档