
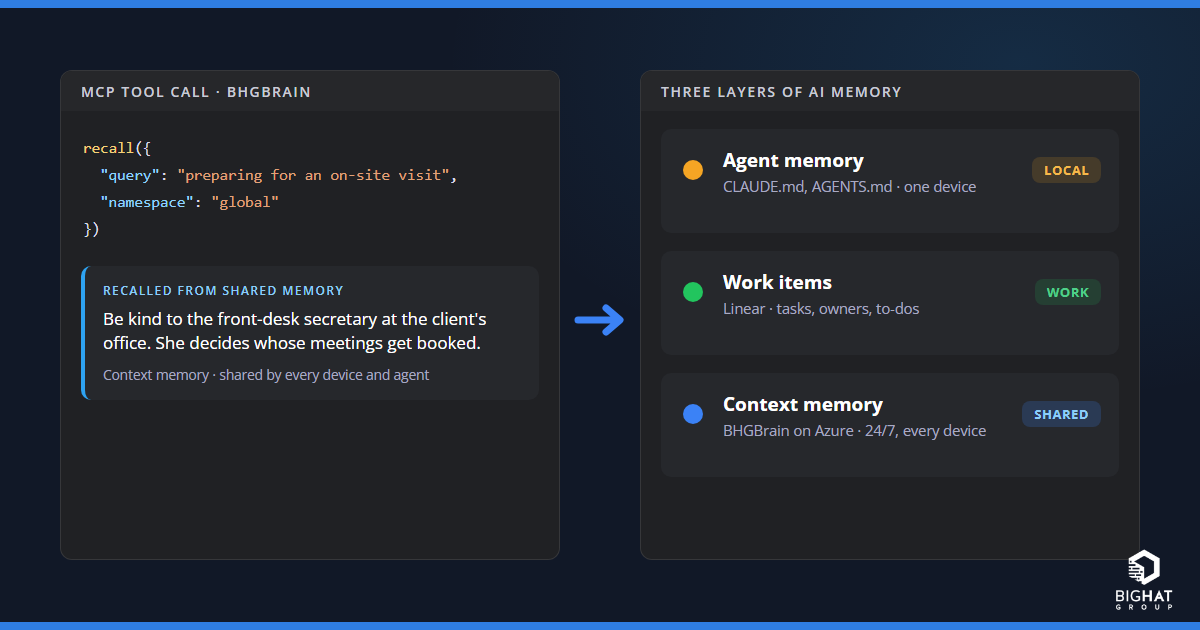
Uso muchos agentes de IA a lo largo del día: Claude Code en un terminal, GitHub Copilot en VS Code, Codex en otra máquina, OpenClaw en un Cloud PC y un puñado de scripts en agentes de compilación. Durante mucho tiempo, cada uno recordaba las cosas en su propio compartimento estanco. Lo que Claude Code aprendía en mi portátil, Copilot en mi equipo de escritorio no lo sabía. Lo que le contaba a un asistente el martes, lo estaba volviendo a explicar el jueves.
A lo largo del último año he llegado a una forma de pensar sobre la memoria de IA que resuelve la mayor parte de esto. Tiene tres capas, y la tercera es donde BHGBrain , nuestro servidor de memoria de código abierto, demuestra su valor. Este artículo explica las tres capas y, después, la arquitectura que hace funcionar la tercera: un único servidor BHGBrain funcionando las 24 horas en una pequeña VM Linux en Azure, accesible de forma privada desde cada dispositivo y cada agente a través de Tailscale.
Las tres capas de la memoria de IA
No toda la información pertenece al mismo sitio. Cuando miro lo que mis agentes necesitan saber, se reparte en tres grupos:
| Capa | Dónde vive | Qué contiene | Ejemplo | Cuánto dura |
|---|---|---|---|---|
| 1. Memoria del agente | Los archivos y la configuración propios de cada agente en un dispositivo: CLAUDE.md, AGENTS.md, memoria integrada | Cómo trabajar en este proyecto con esta herramienta | “Ejecuta el linter antes de cada commit.” | Lo que dure el proyecto |
| 2. Elementos de trabajo | Un sistema de tickets como Linear | Cosas por hacer, quién se encarga y en qué estado están | “Renovar el certificado del cliente antes del viernes.” | Hasta que se cierra el ticket |
| 3. Memoria de contexto | BHGBrain, compartido por todos los dispositivos y agentes | Lo que usted sabe y no es ni una tarea ni una regla del proyecto | “Trate con amabilidad a la recepcionista de la oficina del cliente: es quien decide qué reuniones se programan.” | Mientras siga siendo útil |
Las dos primeras capas se entienden bien. Los archivos de instrucciones para agentes le dicen a una herramienta cómo comportarse en un repositorio. Linear contiene el trabajo: cada tarea pendiente tiene un responsable, un estado y un final.
La tercera capa es la que le falta a la mayoría de la gente. Tome el ejemplo de la recepcionista. No es una tarea, así que no hay nada que abrir o cerrar en Linear. Tampoco es una regla del proyecto: no lo pondría en un CLAUDE.md que se carga en cada sesión de programación y, desde luego, no lo subiría a un repositorio compartido. Y, sin embargo, es justo lo que querría que un asistente recordara cuando le ayuda a preparar una visita a esa oficina.
Mucho conocimiento útil tiene ese aspecto:
- un cliente prefiere las reuniones antes de las 10:00 y detesta los puntos sorpresa en el orden del día;
- la solución que funcionó la última vez que la VPN se cayó en un modelo concreto de portátil;
- cuál de los inquilinos de un cliente es el de producción y cuál es la copia de pruebas;
- por qué se tomó una decisión, no solo qué se decidió;
- el contacto del proveedor que responde al correo pero nunca al teléfono.
Nada de esto es una tarea, y nada de esto es una instrucción para un código fuente. Es contexto: el tipo de cosas que un buen compañero simplemente recuerda. BHGBrain da a sus agentes un lugar donde guardarlo.
Por qué la capa de contexto tiene que estar centralizada
Puede ejecutar BHGBrain en su propio portátil, y es una buena forma de probarlo. Pero una memoria en su portátil es una memoria para su portátil. Está desconectada siempre que el portátil está cerrado, y el equipo de escritorio, el Cloud PC, el entorno WSL y el agente de compilación empiezan todos de cero.
Mi ecosistema de IA no es un solo dispositivo ni un solo proveedor, y sospecho que el suyo tampoco. Para que la capa de contexto sea útil, tiene que ser:
- siempre disponible, las 24 horas del día, para que cualquier agente pueda acceder a ella en cualquier momento;
- accesible desde cualquier dispositivo, ya sea Windows, macOS, Linux, WSL o un Cloud PC de Windows 365;
- utilizable por cualquier agente que hable el Model Context Protocol (MCP), sin estar atada a una herramienta;
- privada, porque contiene justo el tipo de notas que nunca publicaría;
- suya, alojada en su propia suscripción, donde usted controla las copias de seguridad y la retención;
- económica, porque es la memoria de una persona o de un equipo pequeño.
Esa lista apunta a un pequeño servidor propio, en una red privada. Este es el diseño que uso.
La arquitectura: BHGBrain en una VM Linux de Azure
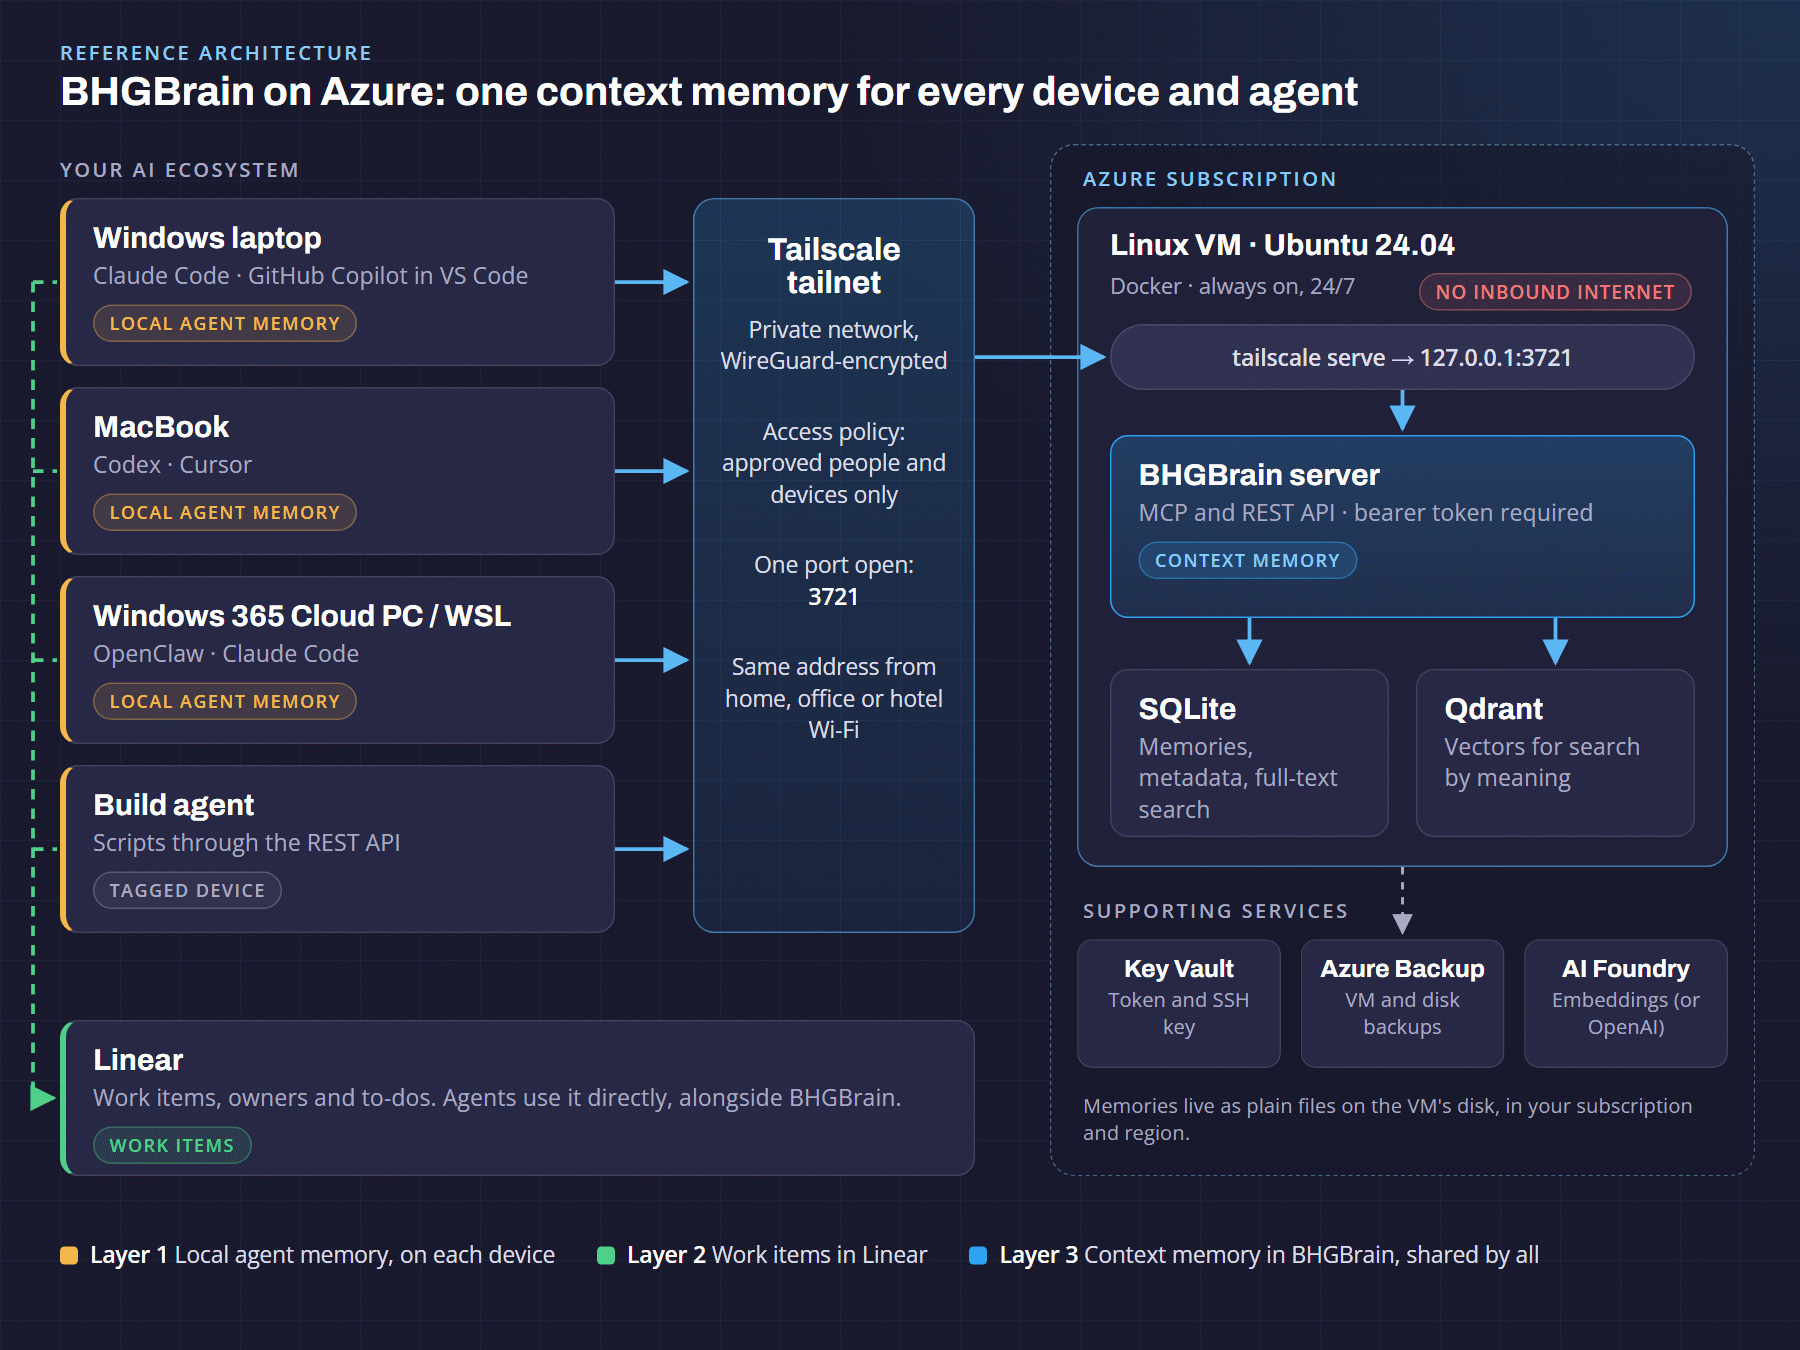
Leyendo el diagrama de izquierda a derecha:
- Sus dispositivos y agentes. Cada portátil, equipo de escritorio, Cloud PC o agente de compilación ejecuta sus herramientas de IA como siempre, y cada herramienta conserva su propia memoria local (capa uno). Las herramientas también se comunican con Linear para los elementos de trabajo (capa dos). Para la capa tres, todas apuntan a la misma dirección: el servidor BHGBrain.
- Una red privada de Tailscale. Cada dispositivo ejecuta Tailscale, que crea una red cifrada (una “tailnet”) entre sus dispositivos, estén donde estén. Una directiva de acceso decide quién puede llegar al servidor de memoria y por qué puerto. Nadie fuera de la tailnet puede verlo.
- Una VM Linux en Azure. Una pequeña VM Ubuntu ejecuta dos contenedores con Docker: el servidor BHGBrain y Qdrant, la base de datos vectorial que usa para la búsqueda por significado. BHGBrain guarda los recuerdos en sí en SQLite, en el disco de la VM. El grupo de seguridad de red de la VM no tiene reglas de entrada, así que nada en internet puede alcanzarla.
- Servicios de Azure de apoyo. Key Vault guarda la clave SSH y el token de acceso. Azure Backup protege el disco. Los embeddings, las “huellas” numéricas que hacen posible la búsqueda por significado, provienen de OpenAI o de Azure AI Foundry, que mantiene ese tráfico dentro de su propio inquilino.
Qué ocurre cuando un agente recuerda algo
Supongamos que estoy en Claude Code en mi portátil y le digo: “Recuerda que la ventana de cambios del cliente es los jueves por la tarde y que las aprobaciones van a su responsable de TI”.
- Claude Code envía una solicitud
remembera la dirección del servidor BHGBrain en la tailnet. - Tailscale comprueba la directiva de acceso. Mi portátil está autorizado, así que la solicitud viaja por el túnel cifrado hasta la VM.
- BHGBrain comprueba el token de acceso de la solicitud, revisa el contenido en busca de cualquier cosa que parezca una contraseña o una clave de API y comprueba si ya conoce ese dato.
- Almacena el recuerdo en SQLite y su embedding en Qdrant, con un nivel de retención que decide cuánto tiempo vive.
Esa misma tarde, en mi equipo de escritorio, Copilot en VS Code pregunta “¿Cuándo es la ventana de cambios del cliente?” y obtiene la respuesta al instante, aunque se guardó desde otra máquina y con otra herramienta.
Por qué una VM Linux en Azure
Hay formas más sencillas y más sofisticadas de alojar un servidor de memoria. Una sola VM da en el punto justo para una persona o un equipo pequeño:
- Siempre está disponible. La memoria está ahí a las 6 de la mañana desde el punto de acceso del teléfono y a medianoche desde un Cloud PC.
- Es sencilla. Dos contenedores y un archivo de configuración. Actualizar consiste en un
git pully un reinicio. Docker lo vuelve a levantar todo después de reiniciar. - Encaja con las herramientas de Azure que ya usa. Azure Backup, Key Vault, Azure Monitor y Azure AI Foundry se integran directamente.
- Sus datos se quedan donde usted los pone. Los recuerdos son archivos normales en un disco de su suscripción y en la región que elija, algo importante si le preocupa la residencia de datos .
- Es económica. Una VM pequeña, no un clúster.
Cómo se compara con las alternativas:
| Opción | Qué obtiene | El inconveniente |
|---|---|---|
| Una copia en cada dispositivo | Nada que alojar | Una memoria distinta por dispositivo. Nada se traslada de uno a otro. |
| Un punto de conexión público con TLS | Accesible desde cualquier lugar, incluidos los asistentes alojados en la nube | Un servidor expuesto a internet lleno de notas privadas, protegido solo por un token. TLS, las reglas de firewall y el riesgo de parches corren por su cuenta. |
| Contenedores administrados | Ningún sistema operativo que parchear | Las bases de datos persistentes y la red privada añaden coste y complejidad para una carga de trabajo de una sola persona. |
| Una VM Linux + Tailscale | Una memoria para todos los dispositivos y agentes, siempre disponible, sin puertos públicos | Una VM es un punto único de fallo, así que haga copias de seguridad. |
Por qué Tailscale en lugar de abrir un puerto
La forma habitual de acceder a un servidor desde cualquier lugar es abrir un puerto a internet y poner un inicio de sesión delante. Para un servidor cuyo único trabajo es recordar cosas privadas, prefiero no hacerlo.
Con Tailscale:
- Sin puertos de entrada desde internet. La VM no acepta conexiones desde internet. Tailscale establece conexiones de salida y construye la red privada a partir de ahí.
- El acceso es por persona y por dispositivo. La directiva de acceso nombra a un grupo de personas autorizadas a usar el servidor de memoria y solo les abre su único puerto. Los administradores además obtienen SSH. Nadie más en su tailnet, y mucho menos en internet, puede conectarse.
- Dos cerraduras, no una. Estar en la tailnet no basta. Cada solicitud sigue necesitando el bearer token de BHGBrain.
- ¿Ha perdido un portátil? Un clic. Quitar un dispositivo en la consola de administración de Tailscale lo deja fuera de inmediato.
- Cifrado en todo momento. El tráfico circula dentro de túneles WireGuard, así que el HTTP simple dentro de la tailnet ya está cifrado del dispositivo a la VM.
- Funciona igual en todas partes. En casa, en la oficina, en el Wi-Fi de un hotel o en la red de invitados de un cliente: la dirección es siempre la misma.
Cómo se comporta como un segundo cerebro
Un segundo cerebro solo funciona si puede echarle cosas sin preocuparse por el desorden. Los niveles de retención de BHGBrain son lo que lo hace posible:
| Nivel | Qué suele acabar ahí | Cuánto dura sin usarse |
|---|---|---|
| T3, transitorio | Números de ticket, resúmenes de correos, notas de “hoy” y “antes del viernes” | 30 días |
| T2, operativo (predeterminado) | Resultados de reuniones, estado de proyectos, investigaciones en curso | 90 días |
| T1, institucional | Decisiones, procedimientos, detalles de proveedores y sistemas | 365 días |
| T0, fundamental | Directivas, reglas permanentes, su perfil | Nunca caduca |
Tres comportamientos hacen que esto se sienta como memoria y no como almacenamiento:
- El uso mantiene vivos los recuerdos. Cada vez que se recupera un recuerdo, su reloj se reinicia. El conocimiento que usa nunca caduca. El conocimiento que nunca usa se limpia solo, y pasa primero a un archivo para que se pueda restaurar.
- Lo que sigue necesitando se promociona. Un recuerdo recuperado cinco veces sube de nivel. Ese dato “suelto” que no deja de consultar se convierte en conocimiento a largo plazo sin que usted haga nada.
- El contexto adecuado aparece en el momento adecuado. Al inicio de una sesión, un agente puede cargar sus reglas permanentes, los recuerdos fijados y los recuerdos más relevantes para la tarea en curso, en lugar de un archivo gigantesco con todo.
También hay tareas de mantenimiento. Los duplicados se fusionan en lugar de acumularse. Las etiquetas se añaden automáticamente. Todo lo que parece una credencial se rechaza antes de almacenarse, algo importante en un cerebro al que alimenta todo el día. Y, si lo activa, un trabajo nocturno de “destilación” condensa grupos de notas relacionadas a corto plazo en un único dato duradero.
El primer día, la entrevista de incorporación integrada en BHGBrain registra su función, sus clientes y sus entornos como recuerdos permanentes, de modo que cada agente en cada dispositivo empieza sabiendo quién es usted.
Un día entre dispositivos
Para concretarlo, este es un día ilustrativo:
- 08:30, portátil con Windows, Claude Code: “Recuerda que la ventana de cambios del cliente es los jueves por la tarde”. Se almacena como dato operativo.
- 09:15, el mismo portátil: “Anota el ticket INC-4821: la VPN se cae en los adaptadores Wi-Fi 6E; desactivar la banda de 6 GHz lo soluciona”. El número de ticket lo marca como transitorio.
- 13:00, equipo de escritorio, Copilot en VS Code: “¿Cuándo es la ventana de cambios del cliente?”. Respondido al instante desde la memoria compartida.
- 15:30, MacBook, Codex: al preparar una visita presencial, el agente recupera la nota sobre la recepcionista junto con las preferencias de reuniones del cliente.
- 17:00, Cloud PC, OpenClaw: inicia una sesión ya preparada con las reglas permanentes y las decisiones recientes del cliente.
- La semana siguiente: la solución provisional de la VPN se ha recuperado desde tres máquinas y se promociona a un nivel de mayor duración. Las notas puntuales que nadie necesitó caducan sin hacer ruido.
Cinco herramientas en cuatro dispositivos, y a ninguna hubo que decirle nada dos veces.
Cuánto cuesta
| Elemento | Coste aproximado | Notas |
|---|---|---|
VM Linux, 2 vCPU y 8 GiB de memoria (Standard_B2ms) | Aproximadamente entre 60 y 70 US$ al mes con tarifas de pago por uso | Un tamaño de 4 GiB cuesta más o menos la mitad y es adecuado para uso personal. Las reservas y los planes de ahorro lo reducen aún más. Consulte la calculadora de precios de Azure para su región. |
| Disco, IP pública para el tráfico de salida, Key Vault, copia de seguridad | De unos pocos dólares a poco más de una decena al mes | Depende del tipo de disco y de la retención de las copias de seguridad |
| Tailscale | Gratis con el plan Personal | El plan Personal es para uso no comercial, con un máximo de seis usuarios. El uso empresarial requiere un plan de pago. |
Embeddings (OpenAI text-embedding-3-small) | 0,02 US$ por millón de tokens | Miles de recuerdos cuestan céntimos |
Para una memoria privada compartida por todas las herramientas de IA que usa, eso es más o menos el precio de unas cuantas suscripciones de streaming.
Concesiones que conviene conocer
Ningún diseño está libre de compromisos. Estos son los que me gustaría que un responsable conociera desde el principio:
- Los conectores alojados en la nube no pueden acceder a él. Los conectores añadidos en claude.ai, en la web o en el teléfono, se ejecutan desde la nube del proveedor, que no está en su tailnet. Los agentes que se ejecutan en sus propios dispositivos funcionan sin problema. Es el precio de mantener el servidor fuera de internet.
- Un único token de acceso compartido. Tailscale controla qué personas y qué dispositivos entran. El token es el mismo para todos, así que rótelo cuando alguien se vaya.
- Una VM es un punto único de fallo. Haga copias de seguridad de los archivos de memoria y de la VM. La base de datos vectorial se puede reconstruir a partir de los recuerdos si se pierde.
- Los embeddings salen de la VM. El texto de los recuerdos se envía al proveedor de embeddings. Usar Azure AI Foundry mantiene ese tráfico dentro de su propio inquilino.
- Piense bien lo que almacena. Las notas sobre personas deberían ser de carácter profesional, de las que no le importaría que esas personas leyeran. Los namespaces mantienen separado el contexto de cada cliente.
Primeros pasos
La guía completa, paso a paso, está en el repositorio de BHGBrain: Deploying BHGBrain on an Azure Linux VM with Tailscale (en inglés). A grandes rasgos:
Prepare la tailnet. Etiquete el servidor, cree un grupo de usuarios y permita que ese grupo acceda solo al puerto del servidor de memoria.
Cree la VM. Una pequeña VM Ubuntu sin reglas de firewall de entrada, con su clave SSH guardada en Key Vault.
Instale Docker y Tailscale. Run Command de Azure lo hace sin abrir SSH a internet.
Inicie BHGBrain. Clone el repositorio, añada el token de acceso y la clave de embeddings, e inicie los dos contenedores.
Publíquelo en la tailnet. Un solo comando
tailscale servelo hace accesible en la misma dirección desde todos los dispositivos.Conecte cada dispositivo. Instale Tailscale y, después, añada el servidor a cada herramienta de IA. En Claude Code es un único comando:
claude mcp add --transport http --scope user bhgbrain \
  http://bhgbrain:3721/mcp --header "Authorization: Bearer <token>"
Enséñele quién es usted. Ejecute la entrevista de incorporación una vez y todos los agentes se beneficiarán.
Qué hacer al respecto
Si su equipo usa más de una herramienta de IA, o la misma herramienta en más de una máquina, ya tiene el problema que esto resuelve. Mis sugerencias:
- Ponga nombre a las tres capas. Acuerden qué va en los archivos de instrucciones para agentes, qué va en Linear y qué va en la memoria de contexto compartida. La mayor parte de la fricción desaparece en cuanto la gente sabe dónde va cada cosa.
- Empiece con una persona. Ejecute BHGBrain para usted mismo en una VM pequeña durante un mes. El valor se nota en lo poco que tiene que repetirse.
- Manténgalo privado de forma predeterminada. Sin puertos públicos, con reglas de acceso de Tailscale, un bearer token y copias de seguridad desde el primer día.
- Crezca de forma deliberada. Añada compañeros a través del grupo de Tailscale, use namespaces para separar a los clientes y decidan juntos qué debe y qué no debe contener la memoria.
Si quiere ayuda para diseñar la parte de Azure, el modelo de acceso o cómo encaja la memoria en su despliegue más amplio de agentes, ese es el tipo de trabajo que hacemos en nuestras prácticas de automatización con IA y consultoría de Azure .
Preguntas frecuentes
¿Qué es un segundo cerebro de IA?
Una memoria compartida y a largo plazo en la que sus asistentes de IA pueden escribir y de la que pueden recuperar información de una sesión a otra. En lugar de volver a explicar sus clientes, entornos y preferencias en cada chat, el asistente guarda lo que aprende y recupera después los fragmentos relevantes. BHGBrain ofrece esto a través del Model Context Protocol, de modo que cualquier agente compatible con MCP puede usarlo.
¿En qué se diferencia BHGBrain de CLAUDE.md, AGENTS.md o la memoria integrada de los agentes?
La memoria local de un agente le indica a una herramienta cómo trabajar en un proyecto en un dispositivo, y normalmente se carga completa en cada sesión. BHGBrain es una capa aparte y compartida para el contexto que abarca proyectos, dispositivos y herramientas: personas, preferencias, detalles de los entornos, lecciones aprendidas y decisiones. Recupera solo lo que es relevante para la tarea.
¿Por qué alojar BHGBrain en una VM de Azure en lugar de en mi portátil?
Una copia en su portátil es una memoria para ese portátil, y está desconectada siempre que lo esté el portátil. Una pequeña VM Linux en Azure funciona 24/7, así que todos los dispositivos y agentes comparten la misma memoria, y obtiene Azure Backup, Key Vault y la opción de embeddings dentro de su inquilino con Azure AI Foundry.
¿Es seguro poner mi servidor de memoria de IA en la nube?
En este diseño la VM no tiene puertos de entrada abiertos a internet. Los dispositivos acceden a ella a través de una red privada de Tailscale a la que solo pueden unirse las personas y los dispositivos aprobados, y cada solicitud sigue necesitando un bearer token. BHGBrain también rechaza, antes de almacenarlo, cualquier contenido que parezca una contraseña o una clave de API.
¿Qué herramientas de IA pueden usar un servidor BHGBrain compartido?
Cualquier cliente MCP en un dispositivo de su tailnet que pueda conectarse a un servidor MCP remoto, como Claude Code, Codex, GitHub Copilot en VS Code, Cursor y OpenClaw, además de scripts que usen la API REST. Las aplicaciones de escritorio que solo inician servidores locales pueden usar un pequeño puente local. Los conectores alojados en la nube no pueden acceder a un servidor que solo está en la tailnet.
Fuentes
- BHGBrain en GitHub , README y documentación del proyecto
- Deploying BHGBrain on an Azure Linux VM with Tailscale , repositorio de BHGBrain
- Comando tailscale serve , documentación de Tailscale
- Precios de Tailscale y actualización de precios de abril de 2026 , Tailscale
- Acceso de salida predeterminado en Azure , Microsoft Learn (por qué la VM necesita una ruta de salida explícita)
- text-embedding-3-small , documentación de OpenAI